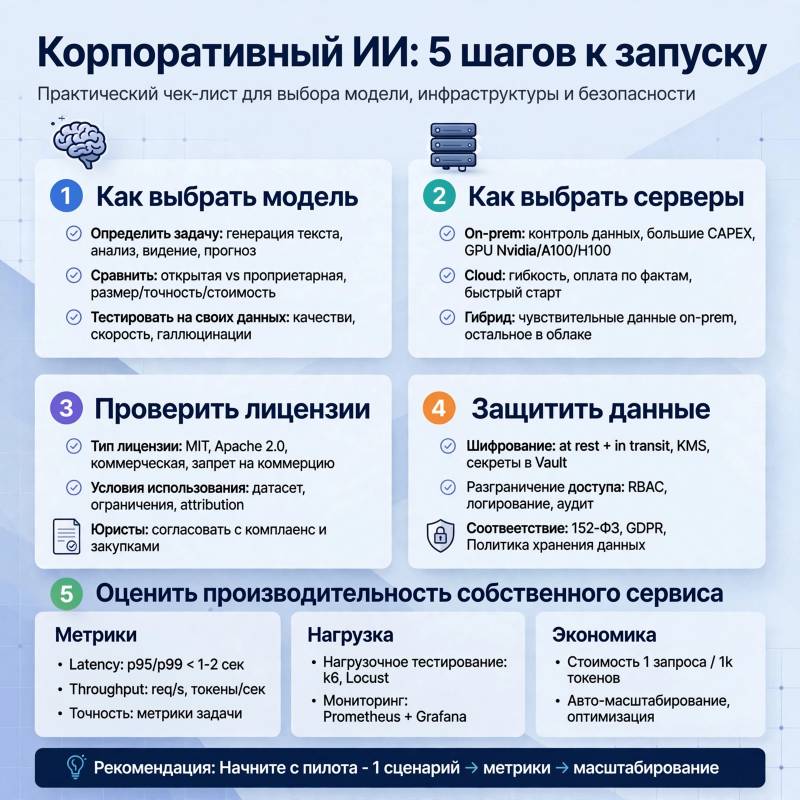
Собственная ИИ-инфраструктура может снизить зависимость от зарубежных API и дать компании больше контроля над данными. Но модель, запущенная в серверной, не становится безопасной и дешёвой автоматически. Нужно выбрать подходящую модель, подготовить вычислительные ресурсы, ограничить доступ к данным и наладить обновления. Иначе вместо управляемого сервиса компания получит дорогостоящий эксперимент.
Начинать стоит не с закупки GPU, а с конкретного сценария: например, поиск по внутренним документам, классификация обращений или помощь разработчикам. Для каждого случая важны свои требования к качеству, скорости ответа и допустимой ошибке. Если задача сводится к извлечению нескольких полей из короткого текста, крупная языковая модель может оказаться избыточной. Иногда достаточно небольшой модели или обычной автоматизации.
Модель, лицензия и данные
Под названием «open-source модель» часто имеют в виду модели с открытыми весами. Это не всегда означает, что открыты обучающие данные, код обучения и все сведения о разработке. Условия использования тоже различаются: лицензия может ограничивать коммерческое применение, отдельные отрасли или число пользователей. Перед внедрением юристам стоит проверить лицензию именно выбранной версии и сопоставить её с планируемым способом использования.
На качество влияют не только размер модели, но и язык, тип запросов, формат ответа и предметная область. Перед выбором составляют набор типичных запросов компании и проверяют несколько кандидатов на одних и тех же примерах. Оценивают не впечатление от пары удачных ответов, а точность, склонность выдумывать сведения, соблюдение формата и поведение на сложных или неполных запросах.
Для работы с внутренними знаниями часто используют генерацию с поиском по документам — RAG. Система находит подходящие фрагменты в корпоративной базе и передаёт их модели вместе с вопросом. Это позволяет обновлять знания без переобучения модели, но не устраняет ошибки: поиск может не найти нужный документ, подобрать устаревший или передать сведения, доступные не тому сотруднику. Права пользователя должны проверяться на уровне поиска, а не только в интерфейсе чата.
Инфраструктура и производительность
Модель можно запускать на CPU, GPU или специализированных ускорителях. CPU-подход иногда подходит для небольших моделей и редких запросов, но обычно уступает GPU по скорости. Требования к видеопамяти зависят от размера модели, точности представления весов, длины контекста и числа одновременных пользователей. Квантование снижает расход памяти и может ускорить работу, но способно ухудшить качество на отдельных задачах — это проверяют на собственных примерах.
Серверная часть обычно включает сервис выдачи ответов, маршрутизатор запросов, хранилище документов, механизм поиска и мониторинг. Для инференса применяют, например, vLLM или llama.cpp: выбор зависит от оборудования, формата модели и ожидаемой нагрузки. Перед запуском полезно измерить задержку первого токена, скорость генерации, расход памяти и поведение при пиковом числе запросов. Среднее время ответа не покажет, что происходит с медленными запросами и очередью в часы пик.
Нагрузку можно снизить ограничением максимальной длины ответа, повторным использованием результатов для одинаковых запросов, пакетной обработкой и маршрутизацией простых задач к меньшей модели. Но экономия не должна незаметно превращаться в ухудшение качества. Изменение модели, квантизации или системной инструкции требует повторной проверки на тестовом наборе.
Безопасность и эксплуатация
Размещение модели внутри сети помогает не отправлять запросы стороннему API, но само по себе не защищает данные. Доступ к сервису и документам нужно выдавать по ролям, секреты хранить отдельно от кода, а сетевые соединения и административные интерфейсы ограничить. В журналах не следует без необходимости сохранять полные запросы с персональными данными, коммерческой тайной и учётными сведениями. Если логи нужны для расследования ошибок, задают сроки хранения и правила доступа к ним.
Модель может ошибаться, а загруженный пользователем текст — содержать инструкции, рассчитанные на обход ограничений. Поэтому действия с последствиями, такие как отправка писем, изменение записей в учётной системе или запуск команд, нельзя поручать модели без отдельной проверки и явного разрешения. Для первого этапа безопаснее оставить ИИ в режиме подготовки черновика, а решение — за сотрудником.
Отдельного внимания требует цепочка поставки: веса модели, контейнеры и библиотеки загружают из проверенных источников, фиксируют версии и проверяют обновления. Важно знать, какие компоненты работают в системе, кто отвечает за исправление уязвимостей и как откатить обновление, если оно нарушило работу сервиса. Для критичных задач нужны резервные копии конфигураций и индексов, а также проверенный план восстановления.
Переход без лишнего риска
Практичный путь — запустить ограниченный пилот на одной задаче, собрать реальные запросы и сравнить результат с текущим процессом. На этом этапе проверяют не только ответы модели, но и стоимость оборудования, потребление энергии, нагрузку на команду эксплуатации и частоту ошибок. Если пилот оправдан, сервис постепенно подключают к большему числу пользователей, сохраняя возможность переключиться на прежний процесс.
Собственный сервер даёт контроль над размещением данных и снижает зависимость от конкретного API, но не устраняет зависимость от производителей ускорителей, программных стеков и лицензий. Полезно заранее предусмотреть переносимость: хранить документы и настройки отдельно от модели, документировать интерфейсы, сохранять тесты качества и иметь альтернативный вариант запуска. Независимость здесь не означает отсутствие внешних компонентов — она означает, что компания понимает свои ограничения и может сменить отдельную часть системы без полной перестройки сервиса.
