CRM для банка, страховой компании или платёжного сервиса — не просто база контактов. Через неё сотрудники видят обращения и историю взаимодействия, а клиентские приложения и контакт-центр могут получать данные о продуктах и статусах заявок. Сбой такой системы не всегда останавливает финансовые операции, но способен лишить сотрудников нужного контекста, задержать обслуживание и привести к ошибочным действиям.
Миллионы клиентов сами по себе не задают архитектуру. Важнее, сколько обращений и изменений данных приходится на пиковый час, какие операции нельзя потерять, как быстро сервис должен восстановиться и сколько времени допустимо показывать устаревшие сведения. Проектирование стоит начинать с этих ответов, а не с выбора облака или базы данных.
Сначала определить границы и требования
Нужно разделить функции CRM и систем, которые действительно ведут финансовый учёт. Остатки на счетах, проводки и статусы платежей обычно должны оставаться в профильных системах. CRM может отображать эти сведения и хранить историю взаимодействия, но не должна становиться их неформальным источником истины. Иначе сбой или рассинхронизация затронут не только обслуживание, но и корректность данных.
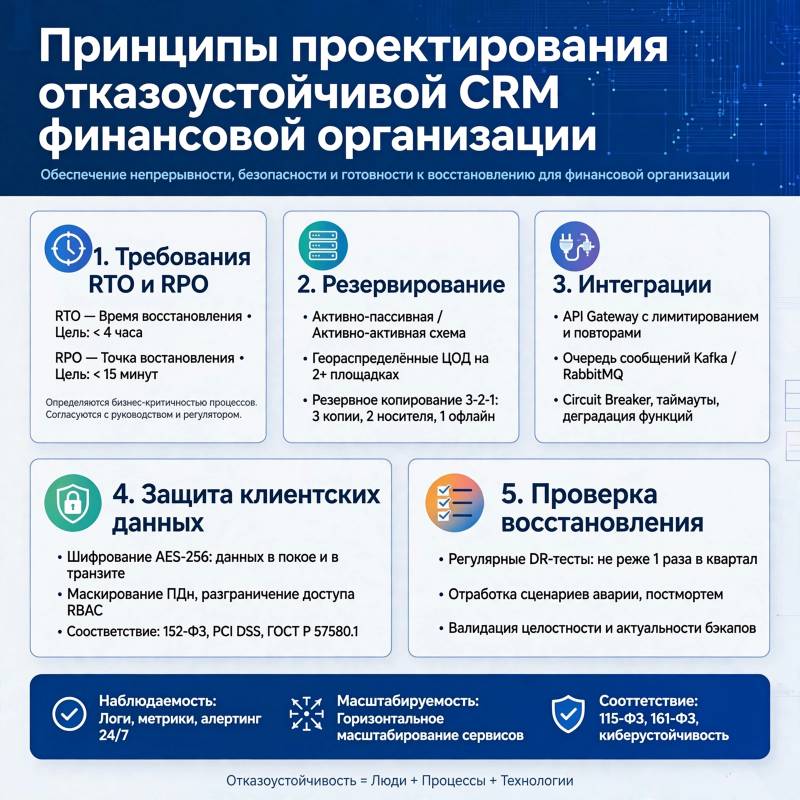
Для каждого критичного сценария задают целевые показатели восстановления. RTO показывает, за какое время сервис необходимо вернуть в работу, а RPO — сколько данных организация готова потерять между аварией и восстановлением. Для очереди обращений и аналитического отчёта требования могут быть разными. Их следует согласовать с владельцами процессов и службой рисков: круглосуточная работа без потери ни одной записи обходится дороже, чем восстановление менее критичной функции за несколько часов.
Отдельно фиксируют нагрузку: обычные и пиковые запросы, массовые кампании, сезонные всплески, объём истории, скорость роста вложений и число интеграций. Средняя нагрузка скрывает самые опасные моменты — например, повторную отправку тысяч событий после восстановления внешнего сервиса.
Архитектура без единственной точки отказа
Клиентские и внутренние приложения обычно обращаются к CRM через API-шлюз. За ним располагаются отдельные сервисы для профиля клиента, обращений, согласий, поиска и других доменов. Такое разделение полезно не само по себе: оно позволяет задавать разные лимиты, масштабировать самые нагруженные функции и ограничивать последствия сбоя одного компонента.
Сервисы размещают как минимум в нескольких независимых зонах доступности, а критичные базы данных и очереди настраивают с репликацией и автоматическим переключением. Резервная копия в том же кластере не заменяет резервирование: она может пострадать от той же ошибки или атаки. Копии следует хранить отдельно и регулярно проверять восстановлением на тестовой среде.
Репликация тоже не равна защите от потери данных. Если ошибочное обновление попало на реплики, оно распространится вместе с корректными изменениями. Поэтому нужны версии записей, журнал изменений, резервные копии с подходящей глубиной хранения и проверенная процедура восстановления на выбранный момент времени.
Мультиоблачная или активная работа в нескольких регионах не обязательна для каждой CRM. Она повышает устойчивость к крупным авариям, но усложняет согласование изменений и управление данными. Часто разумнее начать с нескольких зон в одном регионе, подготовить резервную площадку и перейти к распределённой схеме только после расчёта рисков, требований к задержкам и правил хранения данных.
Данные и интеграции
Для клиентов нужен устойчивый идентификатор, который не зависит от номера телефона или адреса электронной почты: эти значения меняются и могут повторяться. Следует определить правила объединения дублей и разделить подтверждённые сведения, данные из внешних источников и предположения. Если разные системы расходятся в данных, сотрудник должен понимать, откуда пришло значение и когда оно обновлялось.
CRM часто обменивается событиями с банковскими системами, контакт-центром, хранилищем данных и каналами обслуживания. Очереди сообщений помогают переживать кратковременную недоступность получателя, но создают новые требования: ограничение повторов, контроль отложенных сообщений и очередь для событий, которые не удалось обработать. Обработчики должны быть идемпотентными — повторная доставка одного события не должна создавать два обращения или дважды менять согласие клиента.
Для изменений, которые одновременно записываются в базу и отправляются в очередь, полезен шаблон transactional outbox: событие сначала сохраняют вместе с бизнес-изменением, а затем надёжно публикуют. Это снижает риск ситуации, когда запись в CRM уже создана, а уведомление в другую систему потеряно. Для массовой обработки нужны ограничение скорости и возможность возобновить поток без повторного выполнения завершённых операций.
Согласованность данных не везде должна быть мгновенной. Для поискового индекса или отчётности небольшая задержка часто допустима; статус, влияющий на решение сотрудника, может требовать более свежих данных. Если внешняя система недоступна, CRM должна явно показывать устаревшее значение или временную ошибку, а не выдавать старые сведения за актуальные.
Защита данных и непрерывная эксплуатация
Финансовая организация работает с персональными и иногда особо чувствительными данными. Доступ следует выдавать по роли и конкретной задаче, регулярно пересматривать права и фиксировать чтение и изменение важных записей. Шифрование при передаче и хранении, управление ключами, маскирование данных в тестовых средах и контроль выгрузок снижают риск утечки. Конкретные требования к срокам хранения, локализации и обработке данных зависят от юрисдикции и типа организации — их нужно учитывать до выбора схемы размещения.
Журнал аудита не должен незаметно редактироваться пользователями CRM. В нём фиксируют, кто и когда изменил запись, откуда поступили данные и какое действие выполнила система. Для расследований и соблюдения внутренних процедур полезны отдельные правила доступа к журналам и проверка их целостности.
Надёжность поддерживается не только резервированием. Команда должна видеть задержки, долю ошибок, длину очередей, состояние репликации и свободное место. Оповещения настраивают на симптомы, которые требуют действия, а не на каждый краткий скачок метрик. Нужны инструкции для дежурных, понятный порядок переключения и назначенные ответственные за восстановление.
До запуска проверяют не только обычный путь пользователя, но и отказ зоны, переполнение очереди, недоступность внешнего источника и восстановление данных из копии. Нагрузочные тесты должны включать пиковые сценарии и массовые повторы. Такие проверки выявляют, выдерживает ли CRM реальную аварию, а не только красиво выглядит на схеме. Начинать разумно с ограниченного набора критичных функций и измеримых требований, затем наращивать архитектуру там, где данные о нагрузке и рисках показывают реальную необходимость.
