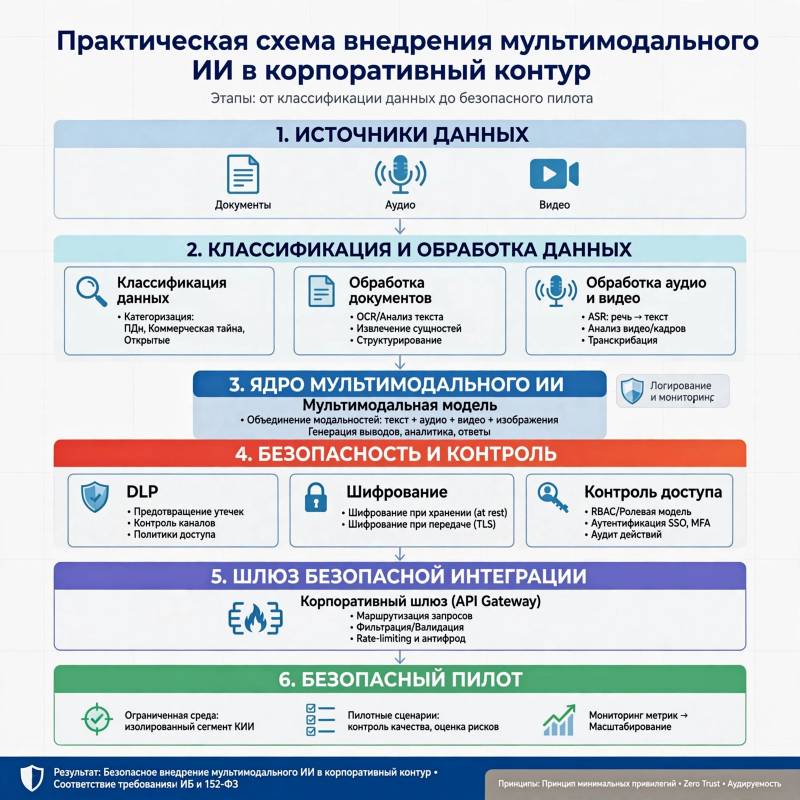
Мультимодальные ИИ-сервисы умеют работать сразу с несколькими типами данных: текстом, сканами, фотографиями, аудиозаписями и видео. Для бизнеса это означает автоматическую обработку договоров, расшифровку переговоров, поиск по видеосовещаниям, извлечение реквизитов из счетов и подготовку кратких справок по внутренним материалам.
Главная сложность здесь не в выборе самой «умной» модели. Корпоративные документы, записи разговоров и видео часто содержат персональные данные, коммерческую тайну, сведения о клиентах и внутренние инструкции. Если отправлять такие файлы в публичный сервис без технических и юридических ограничений, организация теряет контроль над информацией. Надежное внедрение начинается с архитектуры, в которой данные не покидают разрешенный контур без понятного правила и следа в журнале.
Сначала определить, какие данные можно обрабатывать
Нельзя строить единую схему для всех файлов. До пилота стоит составить реестр источников и разделить информацию по уровню чувствительности. В него обычно попадают:
- Открытые материалы — документы, которые уже опубликованы и не содержат внутренних сведений.
- Служебная информация — рабочая переписка, регламенты, презентации и записи совещаний без критичных данных.
- Конфиденциальные сведения — договоры, финансовые документы, клиентские обращения, персональные данные и коммерческие условия.
- Критичные данные — секреты доступа, сведения о системах безопасности, исходный код, данные о здоровье и другая информация с повышенными требованиями к защите.
Для каждой категории заранее задают допустимый способ обработки. Открытые тексты можно направлять в внешний сервис, если это разрешено внутренними правилами. Конфиденциальные файлы разумнее обрабатывать в частном облаке или внутри собственной инфраструктуры. Самые чувствительные данные не должны попадать в модель без маскирования, а иногда их следует исключить из сценария полностью.
Базовая архитектура корпоративного контура
Пользовательский интерфейс не должен обращаться к модели напрямую. Между сотрудником и ИИ нужен корпоративный шлюз, который принимает файл или запрос, проверяет права, определяет класс данных и направляет задачу в разрешенный сервис.
Практическая схема выглядит так:
- Канал загрузки. Сотрудник передает документ, аудио или видео через корпоративное приложение, систему электронного документооборота или защищенный API.
- Предварительная проверка. Шлюз определяет тип файла, размер, наличие вредоносного содержимого и признаки конфиденциальной информации.
- Подготовка данных. Из изображения извлекается текст, аудио переводится в расшифровку, видео разделяется на звук, кадры и метаданные. Лишние фрагменты можно удалить до обращения к языковой модели.
- Маршрутизация. Простая задача отправляется в экономичную модель, а чувствительная — в развернутую внутри защищенного контура. Запросы, которым не соответствует политика, блокируются.
- Проверка результата. Ответ проходит фильтрацию, маркировку и, если требуется, подтверждение сотрудника перед записью в учетную систему.
Такая прослойка дает единое место для контроля доступа, журналирования, ограничения частоты запросов, смены моделей и применения DLP-правил. Если подключить десятки сервисов напрямую к рабочим системам, управлять их настройками и расследовать инциденты будет значительно сложнее.
Как обрабатывать документы, аудио и видео
Документы
Для сканов нужен конвейер OCR, который превращает изображение в текст с координатами и оценкой уверенности распознавания. Это особенно важно для счетов, паспортов, доверенностей и таблиц: одна неверно распознанная цифра может изменить смысл документа. Поля, суммы и реквизиты следует проверять по правилам формата, справочникам и контрольным соотношениям.
Языковая модель может классифицировать документ, найти пункт договора или подготовить черновик карточки. Решение о платеже, подписании или изменении учетных данных лучше оставлять за сотрудником и прикладной системой с формальными проверками.
Аудио
Для записей звонков и совещаний применяют распознавание речи с разделением говорящих, временными метками и словарем терминов компании. До обработки стоит удалять технические паузы и не относящиеся к задаче фрагменты. Если запись содержит персональные данные, доступ к исходному файлу и расшифровке должен различаться: оператору может быть нужен текст, но не вся аудиодорожка.
Результат распознавания желательно считать черновым. Ошибки возможны в именах, номерах договоров, профессиональной лексике и речи с плохим качеством звука. Для протоколов и юридически значимых записей нужна выборочная проверка оригинала.
Видео
Видео требует больше ресурсов и создает больше рисков. Обработка может включать расшифровку речи, извлечение кадров через заданные интервалы, распознавание текста на экране и поиск событий по сценам. Нет необходимости отправлять в модель весь ролик, если задача сводится к поиску упоминания проекта. Сначала можно получить аудиодорожку и технические метаданные, а кадры анализировать только на нужных временных отрезках.
Распознавание лиц, эмоций или поведения требует отдельной правовой и этической оценки. Для внутреннего поиска по видеосовещаниям часто достаточно текста, временных меток и названий экранных материалов.
Меры защиты, которые должны работать постоянно
- Шифрование. Данные защищают при передаче и хранении. Ключи не должны находиться в конфигурационных файлах приложений или быть общими для всех сред.
- Разграничение доступа. Права на исходник, промежуточную расшифровку и ответ модели задают отдельно. Используются корпоративная учетная запись, многофакторная аутентификация и принцип минимально необходимого доступа.
- Маскирование. Имена, телефоны, адреса, номера документов и другие идентификаторы заменяют до отправки в модель, если они не нужны для задачи. Таблица соответствий хранится отдельно и доступна ограниченному числу процессов.
- Контроль хранения. Для каждого типа данных устанавливают срок жизни. Временные файлы, кэш, расшифровки и результаты промежуточных преобразований удаляются автоматически после завершения процесса.
- Журналирование. В журнале фиксируют пользователя, источник файла, цель обработки, выбранную модель, время, результат проверки и факт выгрузки. Содержимое секретных запросов не следует бездумно записывать в обычные логи.
- Защита от подмены инструкций. Документ или субтитры могут содержать текст, который пытается заставить модель раскрыть данные или нарушить правила. Инструкции из пользовательских файлов отделяют от системных правил, а опасные действия требуют подтверждения.
Как выбрать способ размещения
Внешний API удобен для быстрого старта, но нужно проверить, используется ли отправленная информация для обучения, где хранятся запросы, кто имеет доступ к журналам и можно ли отключить сохранение данных. Одного обещания «безопасной обработки» недостаточно: условия должны быть закреплены в договоре и технической документации.
Частное облако дает больше контроля над сетевыми маршрутами, хранилищами и политиками доступа. Собственная установка модели сокращает зависимость от внешнего поставщика, но требует видеокарт, мониторинга, обновлений, резервирования и специалистов. Экономить на этих ресурсах нельзя: медленная или нестабильная система быстро вынуждает сотрудников обходить корпоративные правила.
Как запускать проект без лишнего риска
- Выбрать один-два сценария с понятным эффектом: извлечение реквизитов из счетов, поиск по протоколам или расшифровка внутренних встреч.
- Описать допустимые источники, классы данных, пользователей, срок хранения и критерии качества.
- Провести пилот на обезличенных или специально подготовленных материалах.
- Сравнить не только точность, но и стоимость обработки, задержку ответа, долю ручных исправлений и число заблокированных запросов.
- Проверить систему на утечки, вредоносные файлы, попытки обойти права и подмену инструкций в документах.
- Подключать рабочие данные поэтапно, сохраняя ручное подтверждение для финансовых, кадровых и юридических операций.
Ответственность за внедрение должна быть общей: ИТ отвечает за контур и доступы, служба информационной безопасности — за политики и контроль, юристы — за основания обработки, владельцы процессов — за качество результата. Сотрудникам нужны короткие правила: какие файлы разрешено загружать, что обязательно обезличивать и почему ответ модели нельзя считать окончательным документом.
Безопасный мультимодальный ИИ — это не отдельная программа, а управляемый конвейер с ограниченными маршрутами данных, проверяемыми правилами и понятным участием человека. Если такой конвейер спроектирован до массового запуска, компания получает автоматизацию без превращения корпоративных архивов в неконтролируемый внешний набор данных.
