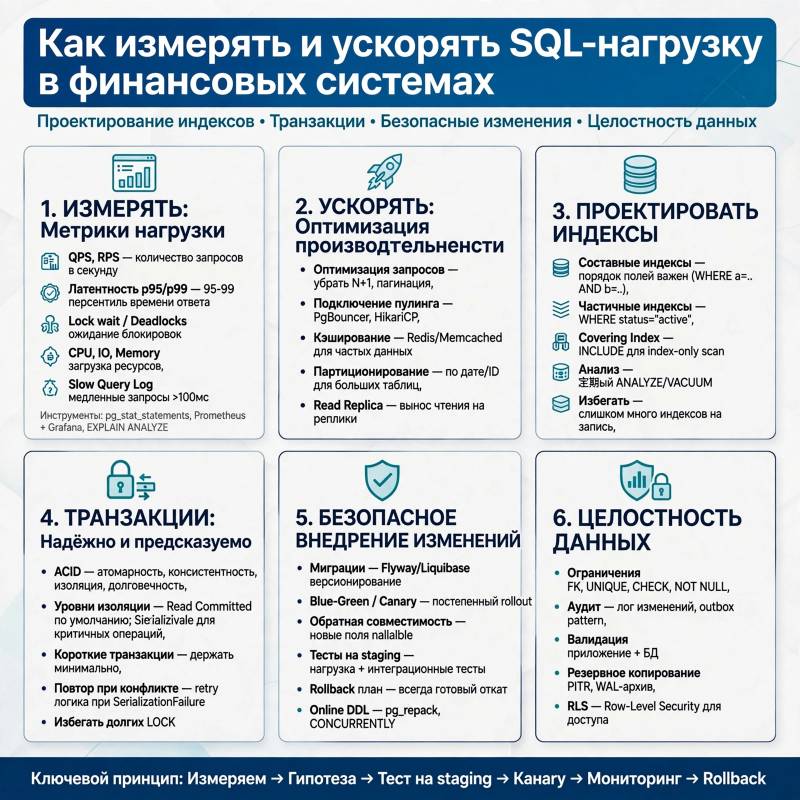
В финансовой системе медленный SQL-запрос — не просто неприятная задержка. Он может увеличить время обработки платежей, задержать закрытие операционного дня или создать очередь транзакций в часы пик. Но ускорение любой ценой опасно: изменение схемы или уровня изоляции способно повлиять на точность балансов, аудит и восстановление после сбоя. Поэтому CTO стоит рассматривать производительность базы вместе с целостностью данных, доступностью и стоимостью изменений.
Начинать лучше не с переписывания самых сложных запросов, а с понимания нагрузки. Важно знать, какие операции идут в транзакционном контуре, какие обслуживают отчётность, где возникают пики и какое время ответа допустимо для каждого сценария. Для перевода и проверки остатка требования обычно отличаются от требований к внутреннему отчёту, который может строиться несколько минут.
Сначала измерения, затем оптимизация
Средние значения скрывают проблемы: у запроса может быть приемлемое среднее время и неприемлемый 99-й перцентиль. Полезно собирать задержки по перцентилям, частоту вызовов, число прочитанных и изменённых строк, ожидания блокировок, ошибки и объём временных данных. Метрики нужно связывать с конкретными операциями, а не только с общим состоянием сервера.
Для приоритизации удобно оценивать совокупную цену запроса: сколько ресурсов он потребляет и как часто запускается. Запрос, который занимает секунду и выполняется раз в сутки, может быть менее важен, чем запрос на 30 миллисекунд, вызываемый тысячи раз в секунду. Отдельно учитывают всплески нагрузки: запас производительности, достаточный в обычный день, может исчезнуть во время массовых выплат или расчёта отчётности.
Следующий шаг — анализ фактического плана выполнения на данных, близких к боевым по объёму и распределению. План показывает, как СУБД читает таблицы, использует индексы, соединяет наборы и сортирует результаты. Внимания заслуживают полные сканирования больших таблиц, неверные оценки числа строк, повторные обращения к одним данным и дорогие сортировки. Само наличие полного сканирования не доказывает ошибку: для небольшой таблицы или запроса, который читает большую часть строк, оно может быть оптимальным.
Запросы, индексы и модель данных
Частая причина лишней работы — запрос, который получает больше данных, чем нужно. Следует выбирать конкретные столбцы, ограничивать набор строк и не загружать большие текстовые или бинарные поля, если они не используются. Постраничное чтение больших результатов обычно надёжнее, чем попытка передать их приложению целиком. Для глубокой пагинации смещение OFFSET может становиться всё дороже; в подходящих сценариях помогает переход по последнему прочитанному ключу.
Индекс ускоряет чтение, но требует места и увеличивает цену записи: его нужно обновлять при изменении данных. Поэтому индексы проектируют под реальные фильтры, соединения и сортировки. Для составного индекса существенен порядок столбцов: он должен соответствовать характерным условиям запросов, а не случайному набору полей. Избыточные и неиспользуемые индексы стоит находить по статистике и удалять только после проверки нагрузки и планов.
Нельзя оптимизировать запрос в отрыве от схемы. Денормализация или дублирование вычисляемых значений иногда сокращают тяжёлые чтения, но создают новые обязанности: согласованно обновлять копии, восстанавливать их и проверять расхождения. Для денег и проводок особенно опасно менять представление данных без чётко заданных правил точности и округления. Схема должна отражать источник истины и обеспечивать проверяемую историю операций, а не только удобство одного отчёта.
Конкурентность и целостность финансовых операций
В загруженной системе узким местом часто становится не вычисление, а ожидание блокировок. Долгие транзакции удерживают ресурсы и мешают другим операциям. Транзакции полезно делать короткими, не выполнять внутри них сетевые вызовы и придерживаться единого порядка захвата ресурсов там, где это возможно. Долгие отчёты не следует без необходимости запускать на том же контуре, где обрабатываются критичные записи: они могут конкурировать за ввод-вывод, память и блокировки.
Уровень изоляции выбирают исходя из гарантий конкретной операции и возможностей СУБД. Ослабление изоляции ради скорости может допустить чтение промежуточных или противоречивых данных; более строгая изоляция способна увеличить число конфликтов и повторов. Для финансовых операций важны атомарность изменений и корректная обработка параллельных запросов. Если клиент повторно отправил запрос после тайм-аута, система должна определить, произошло ли первое выполнение: здесь полезны ключи идемпотентности и надёжная фиксация результата операции.
Реплики для чтения могут разгрузить основной экземпляр, но их отставание нужно учитывать в продуктовой логике. Отчёт, допускающий небольшую задержку, обычно легче отделить от чтения баланса, которое пользователь ожидает увидеть сразу после перевода. Реплика не заменяет согласованный источник данных и не должна незаметно становиться им для операций, где важна актуальность.
Масштабирование без потери управляемости
Партиционирование помогает управлять крупными таблицами, если запросы и обслуживание действительно выигрывают от разделения данных, например по времени. Оно может упростить архивирование и удаление старых диапазонов, но не ускоряет автоматически каждый запрос. Неподходящий ключ разделения способен усложнить соединения и администрирование, поэтому решение проверяют на типичных запросах и сценариях восстановления.
Шардирование — более серьёзный шаг: оно распределяет данные между узлами, но усложняет транзакции, уникальность, миграции и диагностику. До него стоит проверить, исчерпаны ли возможности вертикального масштабирования, настройки запросов, индексов и разделения нагрузок. Для CTO важно заранее оценить не только пропускную способность, но и цену сопровождения, отказоустойчивость и действия при перемещении данных.
Кэширование снимает часть повторных чтений, однако создаёт вопросы свежести и инвалидации. Для справочников и редко меняющихся данных оно может быть уместно; для балансов и состояния платежа цена устаревшего ответа существенно выше. Правило должно быть явным: какие данные разрешено кэшировать, на какой срок и какой компонент остаётся источником истины.
Безопасное внедрение и ответственность команды
Изменения нужно проверять на репрезентативной нагрузке и выпускать поэтапно. До внедрения полезно зафиксировать базовые показатели, проверить планы на реалистичном объёме данных и определить условия отката. Миграции крупных таблиц проводят так, чтобы длительная блокировка не остановила критичные операции; конкретный способ зависит от СУБД и характера изменения. После релиза сравнивают не только скорость целевого запроса, но и задержки соседних операций, ошибки, блокировки и нагрузку на хранилище.
Права доступа, шифрование, аудит и маскирование чувствительных данных нельзя считать помехой производительности, которую допустимо убрать ради ускорения. Диагностические данные и трассировки сами могут содержать персональную или финансовую информацию, поэтому правила их сбора, хранения и доступа должны быть частью проекта оптимизации. Владелец базы, разработчики, эксплуатация и безопасность должны иметь общий процесс разбора деградаций, а не передавать проблему друг другу после инцидента.
Задача CTO — не добиться максимальной скорости одного запроса, а поддерживать предсказуемую систему при росте объёма и нагрузки. Для этого нужны измеримые целевые показатели, проверяемые изменения и ясные компромиссы между задержкой, согласованностью, стоимостью и риском. В финансовой среде хорошая оптимизация незаметна пользователю: операции остаются точными, а система сохраняет запас для пиков и восстановления.
