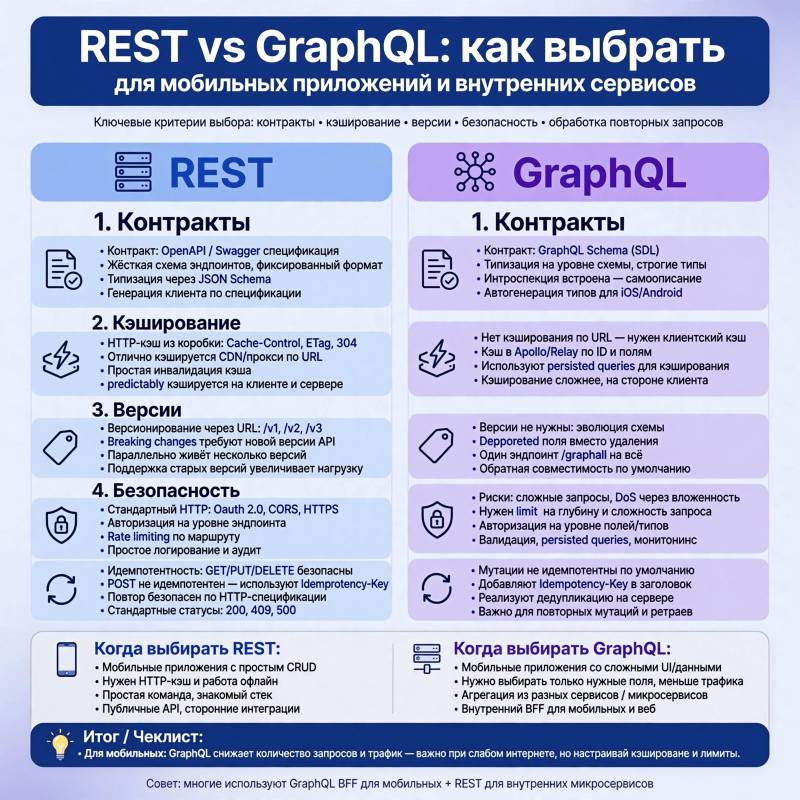
Хорошее API не просто передаёт данные между клиентом и сервером. Оно учитывает нестабильную мобильную сеть, разные версии приложений, нагрузку на внутренние сервисы и правила доступа к данным. REST и GraphQL решают эту задачу по-разному, поэтому выбирать между ними стоит не по популярности, а по характеру запросов и требованиям системы.
Сначала — границы и потребители
До проектирования полезно перечислить клиентов API: мобильное приложение, веб-интерфейс, партнёрские интеграции, фоновые задачи и другие сервисы компании. Для каждого нужны свои ответы на простые вопросы: какие данные он получает, какие операции выполняет, насколько часто меняется и что случится при тайм-ауте или повторном запросе.
Один интерфейс не всегда должен обслуживать всех одинаково. Мобильному клиенту нужен небольшой набор данных для конкретного экрана, а внутренней системе может требоваться подробная сущность для обработки заказа. Различия можно закрыть отдельными API, слоем адаптации для клиента или GraphQL-слоем над существующими сервисами. Главное — не размывать правила предметной области только ради того, чтобы всем клиентам было удобно обращаться к одному endpoint.
Когда удобен REST
В REST ресурсы представлены URL, а стандартные HTTP-методы задают смысл операций: GET читает, POST создаёт или запускает обработку, PUT заменяет представление ресурса, PATCH вносит частичные изменения, DELETE удаляет. Например, заказ может быть доступен по адресу /orders/123. Это понятная модель для CRUD-операций, интеграций и команд, которым нужны прозрачные контракты.
REST хорошо сочетается с возможностями HTTP. Кэширование, условные запросы, коды состояния, заголовки и промежуточная инфраструктура часто работают предсказуемо. Но эти преимущества появляются только при аккуратном проектировании. Если все действия спрятаны в POST-запросах с названиями вроде /doAction, API теряет большую часть ясности.
Для мобильного приложения REST может потребовать нескольких запросов на один экран: отдельно за профилем, списком заказов и настройками. Решение не обязательно в замене протокола. Можно создать агрегирующий endpoint для конкретного сценария, например для стартового экрана, или использовать backend for frontend (BFF) — серверный слой, который собирает данные и адаптирует их под потребности приложения. Такие endpoints должны отражать устойчивые пользовательские сценарии, а не каждую временную композицию интерфейса.
Когда оправдан GraphQL
GraphQL даёт клиенту возможность запросить нужные поля и связанные сущности в одной операции. Это полезно, если экраны собирают данные из нескольких источников, а клиенты заметно отличаются друг от друга. Мобильное приложение может запросить краткую информацию о заказе, тогда как веб-клиент — подробную историю и связанные адреса, не дожидаясь появления отдельных REST-endpoint для каждого представления.
Гибкость здесь не бесплатна. Серверу приходится ограничивать глубину и сложность запросов, задавать лимиты на объём результата и следить за проблемой N+1, когда чтение списка незаметно превращается в множество обращений к хранилищу. Нужны пакетная загрузка данных, метрики по операциям и понятная политика тайм-аутов. Без них клиент может сформировать запрос, который выглядит компактно, но обходится серверу дорого.
Кэширование GraphQL тоже требует отдельного внимания: многие операции отправляются методом POST, а форма запроса у разных клиентов меняется. Используют нормализацию данных на клиенте, persisted queries, кэширование отдельных результатов или HTTP-механизмы для подходящих запросов. GraphQL не отменяет проектирование схемы: имена полей и типов становятся публичным контрактом, а ошибку в нём могут быстро обнаружить сразу несколько команд.
Что особенно важно для мобильных клиентов
Телефон может потерять связь посреди операции, повторить запрос после тайм-аута или долго работать с устаревшей версией приложения. Поэтому API следует проектировать с учётом задержек и повторов. Для операций, которые нельзя выполнить дважды — например, создания платежа или заказа, — полезны ключи идемпотентности: сервер распознаёт повтор и не запускает действие заново. Одного повторного POST после сетевой ошибки недостаточно, чтобы считать операцию безопасной.
Ответы стоит ограничивать по объёму, а списки — выдавать порциями. Курсорная пагинация обычно устойчивее к изменениям списка во время прокрутки, чем смещение и номер страницы; offset-подход проще и может быть вполне достаточен для небольших, редко меняющихся наборов. Выбор зависит от нагрузки и характера данных. Для экономии трафика пригодятся сжатие и условная загрузка, а для офлайн-сценариев — понятные правила синхронизации и разрешения конфликтов.
Версию приложения нельзя приравнивать к версии API. Старые клиенты могут оставаться установленными месяцами, поэтому удаление поля или изменение его смысла способно сломать уже опубликованный релиз. Безопаснее добавлять необязательные поля, сохранять прежнее поведение и заранее измерять использование устаревающих частей контракта. Если несовместимое изменение неизбежно, нужны срок миграции и план поддержки старых клиентов.
Внутренние сервисы: контракт, доступ и наблюдаемость
Для обмена между сервисами важны не только формат запроса, но и владение данными. Команда, отвечающая за сервис заказов, должна определять контракт заказов; соседним системам не стоит напрямую читать его внутреннюю базу. Иначе изменение схемы хранения неожиданно становится изменением нескольких продуктов.
REST удобен для синхронных запросов и хорошо документируется через OpenAPI. GraphQL может быть полезен как единый слой чтения над несколькими сервисами, но превращать его в универсальный транспорт для всех внутренних операций необязательно. Для фоновых процессов и событий, которые не требуют немедленного ответа, часто уместнее очередь или брокер сообщений. Выбор зависит от того, нужна ли вызывающей стороне немедленная реакция и что делать при недоступности получателя.
Контракт должен описывать типы данных, обязательность полей, формат ошибок и правила пагинации. В REST полезно последовательно применять коды HTTP и возвращать машинно-читаемое описание ошибки. В GraphQL ошибки могут приходить вместе с частично сформированными данными, поэтому клиенту нужно понимать, какие части ответа пригодны к использованию. Документация и автоматические проверки совместимости помогают обнаружить проблемы до выкладки.
Наконец, права доступа проверяют на сервере для каждой операции и каждого объекта, а не только при входе пользователя. Для GraphQL это означает проверку доступа к полям и связанным сущностям; для REST — проверку права на конкретный ресурс, а не только на endpoint. Журналы и трассировка должны связывать запрос с его дальнейшими вызовами, не записывая пароли, токены и чувствительные данные. Метрики задержки, ошибок и нагрузки показывают, где контракт или реализация создают реальные проблемы.
На практике часто работает сочетание подходов: REST для стабильных операций и интеграций, GraphQL для сложных клиентских представлений, асинхронные события для фоновых процессов. Такой выбор оправдан, когда у каждого интерфейса есть понятные потребители, владелец контракта и правила эволюции. Именно эти договорённости, а не название технологии, определяют, насколько API переживёт рост продукта и смену клиентов.
